Google Indexierung: prüfen, beantragen, Fehler beheben
Google Indexierung prüfen und beantragen: URL-Prüfung, Statusmeldungen der Search Console übersetzt, Fehler beheben. Mit Prüfliste als PDF.
Inhaltsverzeichnis anzeigen
- In drei Stufen in den Google-Index
- Google Indexierung prüfen und beantragen in drei Schritten
- Schnellcheck mit site: nur als grober Anhaltspunkt
- Die Prüfkette als Entscheidungsweg
- Statusmeldungen der Search Console übersetzt
- „Gecrawlt, zurzeit nicht indexiert“: wann du handeln solltest
- „Gefunden, zurzeit nicht indexiert“: Google hat noch nicht gecrawlt
- Wenn Google eine andere kanonische URL wählt
- Neue Seite bei Google indexieren lassen: schneller in den Index
- Typische Fehler, die Seiten aus dem Index halten
- Wenn das Muster mehrere Seiten betrifft
- Häufige Fragen zur Google Indexierung
- Wie lange dauert die Indexierung bei Google?
- Wie beantrage ich die Indexierung bei Google?
- Wie prüfe ich, ob meine Seite bei Google indexiert ist?
- Was bedeutet „Gecrawlt, zurzeit nicht indexiert“?
- Was bedeutet „Gefunden, zurzeit nicht indexiert“?
- Warum indexiert Google meine Seite nicht?
- Ist „Seite mit Weiterleitung“ ein Fehler?
Die Google Indexierung entscheidet, ob eine Seite überhaupt in den Suchergebnissen erscheinen kann. Steht sie nicht im Index, findet sie über Google niemand, egal wie gut der Text ist. Die kurze Antwort: Google muss deine Seite finden, abrufen und danach selbst entscheiden, ob sie aufgenommen wird. Ob das passiert ist, zeigt dir die URL-Prüfung in der Google Search Console. Dort kannst du die Indexierung auch beantragen, aber erst, wenn kein Hindernis mehr im Weg steht. Eine Garantie für die Aufnahme gibt es auch dann nicht.
- Drei Stufen: Google findet eine Adresse, ruft sie ab und entscheidet dann, ob sie in den Index kommt. Gecrawlt heißt noch nicht indexiert.
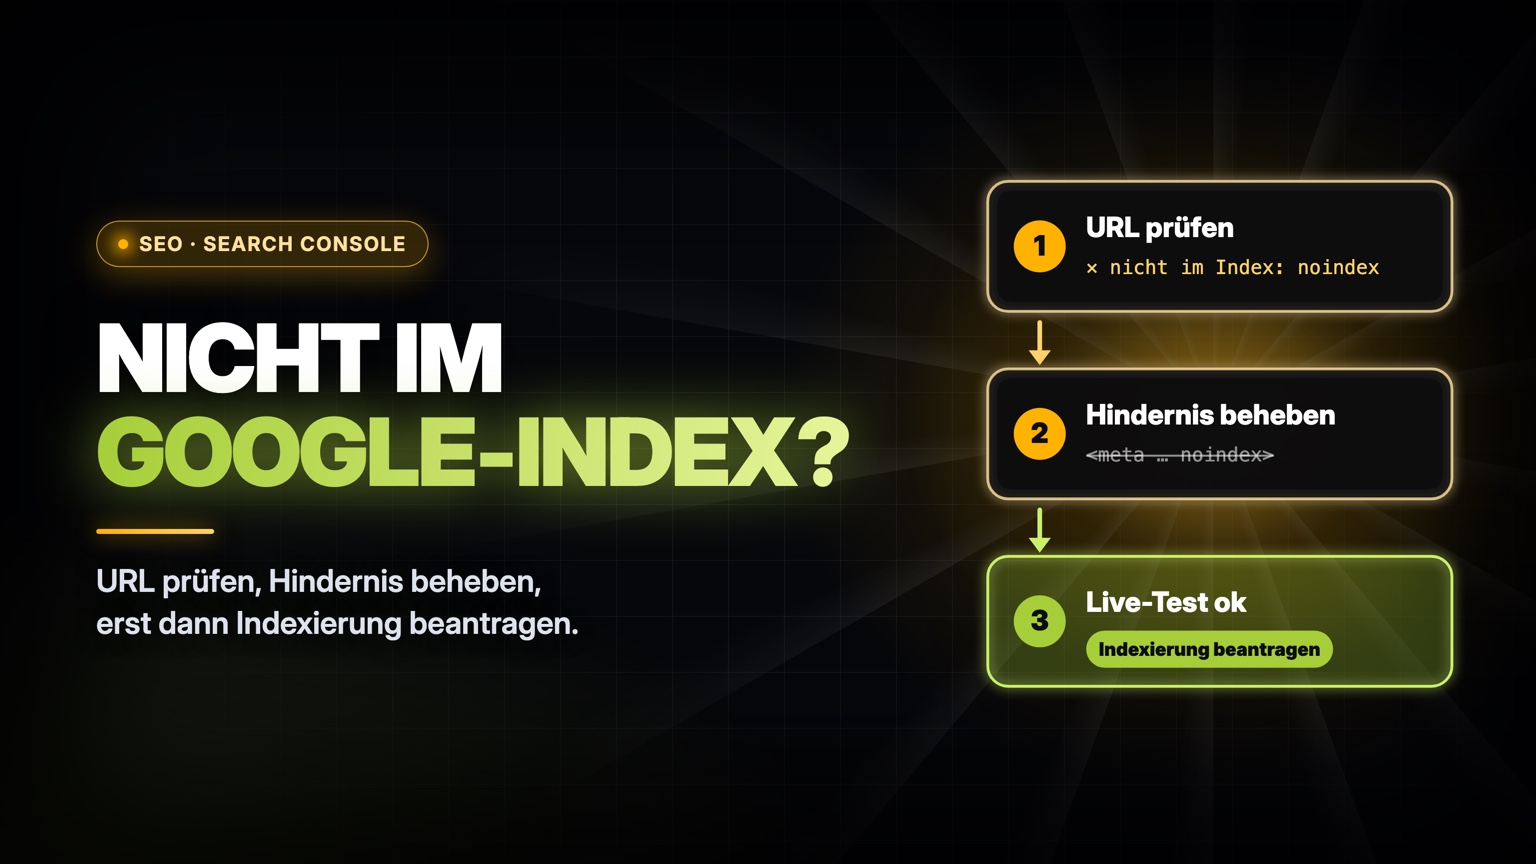
- Feste Reihenfolge: URL prüfen → Hindernis beheben → gegebenenfalls Indexierung beantragen. Wer den Grund nicht kennt, beantragt ins Leere.
- Zwei Ansichten in der URL-Prüfung: Die indexierte Version zeigt, was Google zuletzt gespeichert hat. Der Live-Test zeigt, ob Google die Seite jetzt abrufen kann.
- Nicht jeder Ausschluss ist ein Fehler: Manche sind gewollt. Handlungsbedarf entsteht erst, wenn eine Seite betroffen ist, die in den Index soll.
- Mehrfach beantragen hilft nicht: Für Anträge gilt ein Tageslimit, und eine Adresse wird durch mehrere Anfragen nicht schneller gecrawlt.
In drei Stufen in den Google-Index
Vereinfacht durchläuft eine Seite drei Stufen, bis sie im Index steht. Google selbst spricht von Crawlen, Indexieren und Bereitstellen in den Suchergebnissen; das Finden der Adresse gehört dort zum Crawlen. An jeder Stufe kann eine Seite hängen bleiben, und die Search Console nennt dafür eigene Gründe.
Google erfährt von der Adresse, etwa über einen Link auf einer anderen Seite oder über deine Sitemap.
Der Googlebot ruft die Seite ab. Verbietet die robots.txt den Abruf oder antwortet der Server mit einem Fehler, kann Google den Inhalt nicht lesen.
Google wertet den Inhalt aus, prüft, ob die Seite ein Duplikat einer anderen ist, und entscheidet über die Aufnahme.
Daraus folgt der wichtigste Unterschied für die Fehlersuche: Gecrawlt heißt nicht indexiert. Die Begriffe stehen kurz erklärt im Glossar unter Indexierung. Und indexiert heißt noch nicht gut platziert. Wo eine Seite in den Ergebnissen erscheint, ist eine eigene Frage, um die es im Ratgeber Google-Ranking verbessern geht.
Google Indexierung prüfen und beantragen in drei Schritten
Bevor du irgendetwas beantragst, gilt eine feste Reihenfolge: URL prüfen → Hindernis beheben → gegebenenfalls Indexierung beantragen. Ohne den Grund für den Ausschluss schickt ein Antrag Google womöglich nur erneut zu einer Seite, die aus demselben Grund draußen bleibt.
- 1
URL in der Search Console prüfen
Gib die vollständige Adresse in die URL-Prüfung der Search Console ein. Zuerst siehst du die indexierte Version. Das ist kein Live-Test, sondern der Stand, den Google zuletzt gespeichert hat. Steht die Seite im Index, bist du an dieser Stelle fertig. Ist sie ausgeschlossen, nennt die Prüfung den Grund, etwa URL als „noindex“ markiert. Mit „Live-URL testen“ ruft Google die Seite dagegen in Echtzeit ab. Der Vergleich beider Ansichten zeigt, ob ein Hindernis schon behoben ist und Google das nur noch nicht gesehen hat.
Prüfen: Indexstatus, Grund des Ausschlusses und bei Duplikaten die von Google ausgewählte kanonische URL. Die kanonische URL zeigt nur die indexierte Version, nicht der Live-Test. - 2
Hindernis beheben
Der Grund aus der URL-Prüfung bestimmt den nächsten Schritt. Was die einzelnen Meldungen bedeuten und wo du ansetzt, steht in der Tabelle im nächsten Abschnitt. Behebe das Hindernis an der Quelle, also in der Vorlage, im Plugin, in der Servereinstellung oder in der robots.txt. Betrifft das Muster mehrere Adressen, reicht die Korrektur an einer einzelnen Seite nicht. Danach testest du die Live-URL erneut.
Prüfen: Der Live-Test stuft die Seite als indexierbar ein. Beachte dabei: Ob eine Seite ein Duplikat oder eine alternative Fassung ist, prüft der Live-Test nicht. - 3
Indexierung beantragen, wenn es sich lohnt
Ist der Live-Test sauber, klickst du auf „Indexierung beantragen“. Dafür musst du Inhaber oder vollwertiger Nutzer der Property sein. Stuft der Live-Test die Seite als nicht indexierbar ein, lässt sich keine Indexierung anfordern. Für die Anträge gilt ein Limit pro Tag, eine feste Zahl nennt Google nicht. Hast du viele Adressen, reichst du stattdessen eine Sitemap ein.
Prüfen: Nach einigen Tagen die URL-Prüfung wiederholen, nicht den Antrag.
Was der Antrag nicht bringt
- Keine sichere Aufnahme: Laut Google ist eine Crawling-Anfrage keine Garantie dafür, dass die Seite sofort oder überhaupt in die Suchergebnisse aufgenommen wird. Auch ein bestandener Live-Test belegt nur, dass Google die Seite abrufen kann.
- Kein schnellerer Crawl: Eine Adresse wird nicht schneller gecrawlt, wenn du die Anfrage mehrmals stellst.
- Kein Werkzeug für jede Kleinigkeit: Google crawlt Seiten ohnehin regelmäßig neu. Einen Antrag empfiehlt Google bei einer wichtigen Änderung, die es eine Woche oder länger nicht bemerkt hat.
Quellen: Google Search Central, Crawling durch Google anfordern, und Search-Console-Hilfe, URL-Prüftool.
Schnellcheck mit site: nur als grober Anhaltspunkt
Schneller als die Search Console geht eine Suche mit dem Operator site:, etwa site:example.com/leistungen. Erscheint die Adresse in den Ergebnissen, steht sie im Index. Erscheint sie nicht, beweist das wenig. Laut Google gibt eine site:-Abfrage nicht unbedingt alle indexierten Adressen zurück, und site:https://www.example.com liefert andere Ergebnisse als site:https://example.com/. Für eine verlässliche Antwort zu einer einzelnen Seite nimmst du deshalb die URL-Prüfung (Google zum site:-Operator).
Die Prüfkette als Entscheidungsweg
Das Schaubild fasst die drei Schritte als Entscheidungsweg zusammen, mit einer Abzweigung je Frage.
Das Schaubild in Kürze:
- Frage 1, URL-Prüfung: Steht die Seite im Index? Ja: indexiert, ob die Seite gut rankt, ist eine eigene Frage. Nein: weiter mit Frage 2.
- Frage 2, Grund lesen: Ist der Ausschluss gewollt? Ja: nichts tun. Meist gewollt sind etwa „Seite mit Weiterleitung“, „Alternative Seite mit richtigem kanonischen Tag“ und ein bewusst gesetztes noindex. Nein: weiter mit Frage 3.
- Frage 3, Hindernis beheben und Live-Test: Ist die Seite indexierbar? Nein: weiter beheben und noindex, robots.txt, Weiterleitung, Server- und 404-Fehler prüfen. Ja: Indexierung beantragen, dann nach einigen Tagen die URL-Prüfung wiederholen.
Statusmeldungen der Search Console übersetzt
Den Grund für einen Ausschluss nennt der Bericht zur Seitenindexierung in der Search Console, für eine einzelne Adresse die URL-Prüfung. Google ordnet nicht indexierte Seiten dabei ausdrücklich nicht pauschal als Fehler ein. Ob du handeln musst, ergibt sich erst aus der konkreten Meldung und aus der Frage, ob die Seite überhaupt in den Index soll.
Die Tabelle übersetzt die Meldungen ins Praktische. Die Namen folgen der deutschen Google-Hilfe zum Bericht Seitenindexierung. Wo Google in einem Namen einen Strich setzt, steht hier ein Komma oder Doppelpunkt, und in deiner Oberfläche kann die Formulierung leicht abweichen. Die Spalte „Mögliche Ursache“ nennt typische Auslöser, keine Diagnose für deinen Einzelfall.
| Meldung | Was sie heißt | Mögliche Ursache | Erster Schritt | Einordnung |
|---|---|---|---|---|
| Serverfehler (5xx) | Der Server hat beim Abruf mit einem 5xx-Fehler geantwortet. | Server überlastet, fehlerhafte Erweiterung, Ausfall zum Zeitpunkt des Abrufs | Seite selbst aufrufen, Fehlerprotokoll des Servers prüfen, danach Live-Test | ✕ Handlungsbedarf |
| Weiterleitungsfehler | Google ist an einer Weiterleitung gescheitert. | zu lange Weiterleitungskette, Weiterleitungsschleife, zu lange oder leere Ziel-URL | Alte Adresse direkt auf das endgültige Ziel weiterleiten | ✕ Handlungsbedarf |
| Soft 404-Fehler | Die Seite wirkt auf Google wie eine Fehlerseite, liefert aber keinen 404-Code. | Text „Nicht gefunden“ mit Statuscode 200, leere Seite, Seite ohne Hauptinhalt | Echte Fehlerseiten mit 404 ausliefern, sonst der Seite Inhalt geben | ✕ Handlungsbedarf |
| Wegen Zugriffsverbot (403) blockiert | Der Server verweigert den Zugriff. Der Googlebot sendet nie Anmeldedaten. | Schutz- oder Firewall-Regel, falsch gesetzte Zugriffsrechte | Zugriff für nicht angemeldete Besucher oder für den verifizierten Googlebot erlauben | ✕ Handlungsbedarf |
| Gefunden, zurzeit nicht indexiert | Google kennt die Adresse, hat sie aber noch nicht gecrawlt. | normalerweise: Google hat den Abruf verschoben, weil das Crawlen die Website überlastet hätte | Abwarten; bei vielen betroffenen Seiten empfehle ich, Antwortzeiten und unnötige Adressen zu prüfen | ◇ Je nach Seite |
| Gecrawlt, zurzeit nicht indexiert | Google hat die Seite abgerufen, aber nicht aufgenommen. | nicht unbedingt ein Fehler. Google nennt als Beispiel eine Sperre für Crawler. Bei wichtigen Seiten kommt auch wenig eigener Inhalt infrage. | URL-Prüfung, dann Inhalt und interne Verlinkung der Seite prüfen | ◇ Je nach Seite |
| Duplikat: Google hat eine andere Seite als der Nutzer als kanonisch bestimmt | Google hat deine kanonische Angabe überstimmt und eine andere Seite indexiert. | Seiten ähneln sich zu wenig oder Signale wie Weiterleitung, Canonical und Sitemap widersprechen sich | In der URL-Prüfung die von Google ausgewählte mit der vom Nutzer angegebenen kanonischen URL vergleichen | ◇ Je nach Seite |
| URL wird von der robots.txt-Datei blockiert | Die robots.txt verbietet Google den Abruf. | bewusste Sperre oder eine aus der Testphase übernommene Sperre | Soll die Seite in den Index: Sperre entfernen. Soll sie sicher draußen bleiben: Sperre entfernen und noindex setzen | ◇ Je nach Ziel |
| Indexiert, obwohl durch robots.txt-Datei blockiert | Google hat die Adresse aufgenommen, obwohl der Abruf gesperrt ist. | andere Seiten verlinken auf die gesperrte Adresse | Soll sie draußen bleiben: Sperre entfernen und noindex setzen | ◇ Je nach Ziel |
| URL als „noindex“ markiert | Google hat eine noindex-Anweisung gefunden und die Seite deshalb nicht aufgenommen. | bewusst gesetzt oder nach Testphase oder Relaunch stehen geblieben | Soll die Seite in den Index: noindex entfernen, Live-Test, Indexierung beantragen | ◇ Je nach Ziel |
| Nicht gefunden (404) | Die Adresse liefert einen 404-Fehler. | Seite gelöscht, umgezogen oder ein fehlerhafter Link | Umgezogen: 301-Weiterleitung auf die neue Adresse. Ersatzlos entfernt: nichts tun | ◇ Je nach Ziel |
| Wegen nicht autorisierter Anforderung (401) blockiert | Die Seite verlangt eine Anmeldung. | Kundenbereich, passwortgeschützte Testumgebung | Geschützte Bereiche so lassen. Soll die Seite in den Index: Anmeldung entfernen oder den Googlebot nach Identitätsprüfung zulassen | ◇ Je nach Ziel |
| Duplikat: vom Nutzer nicht als kanonisch festgelegt | Google hält die Seite für ein Duplikat und hat eine andere als kanonisch gewählt. | nahezu gleiche Seiten ohne kanonische Angabe | Prüfen, ob Google die richtige Fassung gewählt hat, sonst die kanonische URL angeben | ✓ Meist gewollt |
| Alternative Seite mit richtigem kanonischen Tag | Die Seite verweist korrekt auf eine indexierte kanonische Seite. | mobile Fassung, AMP-Seite oder Desktop-Fassung einer anderen Seite | Nichts tun | ✓ Gewollt |
| Seite mit Weiterleitung | Die Adresse leitet weiter und wird deshalb nicht indexiert. | Weiterleitung nach einem Umzug oder auf die bevorzugte Schreibweise der Adresse | Nichts tun, nur prüfen, ob das Ziel der Weiterleitung indexiert ist | ✓ Meist gewollt |
Einordnung: ✕ Handlungsbedarf, wenn die Seite in den Index soll. ◇ Hängt davon ab, ob die Seite wichtig ist oder in den Index soll. ✓ Ein Ausschluss, der so gedacht ist.
Außerdem nennt Google zwei seltenere Meldungen: Bei „URL wegen eines anderen 4xx-Problems blockiert“ empfiehlt Google, den Fehler mit dem URL-Prüftool einzugrenzen. „Seite ohne Inhalt indexiert“ heißt, die Seite steht im Index, aber Google konnte ihren Inhalt nicht lesen, etwa wegen Cloaking oder eines Formats, das Google nicht indexieren kann.
„Gecrawlt, zurzeit nicht indexiert“: wann du handeln solltest
Diese Meldung (englisch: Crawled, currently not indexed) heißt: Google hat die Seite abgerufen, aber nicht in den Index aufgenommen. Laut Google ist sie für viele Websites üblich und weist nicht unbedingt auf etwas hin, das du beheben musst. Interessant wird sie bei Seiten, die dir wichtig sind. Für diesen Fall rät Google, mit dem URL-Prüftool und anderen Tools zu klären, ob etwas auf deiner Website die Anzeige verhindert, zum Beispiel eine Sperre für die Crawler.
Beispiel
Angenommen, ein Handwerksbetrieb hat für zwölf Orte im Umland je eine eigene Seite angelegt. Die Texte sind bis auf den Ortsnamen gleich. Im Bericht stehen acht dieser Seiten unter „Gecrawlt, zurzeit nicht indexiert“.
Ich würde zuerst eine der acht Seiten in der URL-Prüfung ansehen, um eine Sperre für Crawler auszuschließen. Ist technisch alles in Ordnung, würde ich die Ortsseiten zusammenlegen oder jeder Seite eigenen Inhalt geben, etwa Anfahrt, Ansprechpartner und Arbeiten aus dem jeweiligen Ort.
Einen Beleg, dass Google genau deshalb aussortiert, liefert die Meldung nicht. Google schreibt aber, dass seine Systeme die Indexierung qualitativ hochwertiger und nützlicher Inhalte priorisieren.
„Gefunden, zurzeit nicht indexiert“: Google hat noch nicht gecrawlt
Bei dieser Meldung (englisch: Discovered, currently not indexed) kennt Google die Adresse, hat sie aber noch nicht abgerufen. Laut Google wollte der Googlebot die URL in diesem Fall normalerweise crawlen. Das hätte die Website aber überlastet, deshalb hat Google das Crawling neu geplant. Darum ist im Bericht auch das Feld mit dem letzten Crawling-Datum leer. Wie lange es bis zum nächsten Versuch dauert, nennt Google nicht.
Beispiel
Angenommen, ein Onlineshop stellt an einem Tag mehrere tausend neue Produkt- und Filterseiten online. Ein Großteil davon erscheint kurz darauf unter „Gefunden, zurzeit nicht indexiert“.
Bevor ich hier etwas beantrage, würde ich drei Dinge prüfen: Antwortet der Server auch unter Last zügig? Erzeugt der Shop unnötige Adressen, etwa für jede Filterkombination? Und enthält die Sitemap nur die Seiten, die tatsächlich in den Index sollen? Einzelne Anträge helfen bei tausenden Adressen ohnehin nicht, dafür ist die Sitemap da.
Wenn Google eine andere kanonische URL wählt
Bei Duplikaten entscheidet Google, welche Fassung in den Index kommt. Eine Angabe per rel="canonical" nennt Google ein starkes Signal, ebenso eine Weiterleitung. Die Aufnahme in die Sitemap ist dagegen nur ein schwaches Signal. Gibst du nichts an, ermittelt Google die aus seiner Sicht beste Version selbst. Welche Seite Google gewählt hat, siehst du in der URL-Prüfung: Dort findest du die vom Nutzer angegebene und die von Google ausgewählte kanonische URL. Weichen beide ab, prüf zuerst, ob sich die Seiten wirklich ähneln. Laut Google muss eine duplizierte Seite der kanonischen ähneln (Google-Hilfe zur Seitenindexierung). Wie Google kanonische URLs bestimmt, beschreibt die Seite kanonische URLs festlegen.
Neue Seite bei Google indexieren lassen: schneller in den Index
Eine Abkürzung, die die Aufnahme sicher beschleunigt, gibt es nicht. Du kannst Google aber das Finden leichter machen. Zur Dauer nennt Google selbst nur grobe Werte: Bei einer neuen Website kann es einige Wochen dauern, bis Google sie oder Änderungen daran bemerkt. Für ein angefordertes Crawling nennt Google einige Tage oder mehrere Wochen.
- Sitemap einreichen: im Sitemaps-Bericht der Search Console. Eine Sitemap hilft Google, die Adressen deiner Website zu finden. Dass jede davon gecrawlt und indexiert wird, stellt sie nicht sicher. Besonders nützlich ist sie für neue Websites mit wenigen Links von außen und für große Websites. Eine einzelne Sitemap fasst höchstens 50.000 URLs oder 50 MB unkomprimiert.
- Neue Seiten intern verlinken: von passenden Seiten, die Google schon kennt, etwa der Leistungsübersicht oder einem verwandten Ratgeber. Google findet neue Seiten vor allem über Links und die Sitemap.
- Einzelne wichtige Seiten beantragen: nach einem sauberen Live-Test in der URL-Prüfung. Für viele Adressen ist die Sitemap der bessere Weg.
- Sperren der Testphase vor dem Start entfernen: noindex, Passwortschutz und Sperren in der robots.txt, die auf der Testumgebung richtig waren.
- Indexing API nur für Sonderfälle: Sie ist auf Seiten mit Stellenanzeigen (JobPosting) und Livestream-Videos (BroadcastEvent in einem VideoObject) beschränkt und kein allgemeiner Weg in den Index.
Quellen: Google Search Central, Sitemaps im Überblick, So erscheinst du in der Google Suche und Indexing API.
Typische Fehler, die Seiten aus dem Index halten
Bevor du nach seltenen Ursachen suchst, schließ diese fünf Fehler aus. Alle zeigen sich in der URL-Prüfung oder im Bericht zur Seitenindexierung.
Fünf Fehler, die du zuerst ausschließen solltest
- noindex aus der Testphase: Eine noindex-Anweisung, die auf der Testumgebung richtig war, bleibt nach dem Start im Seitenkopf stehen. Die URL-Prüfung meldet dann URL als „noindex“ markiert.
- robots.txt statt noindex: Die robots.txt sperrt den Abruf, nicht die Aufnahme in den Index, und ein noindex sieht Google nur auf Seiten, die es abrufen darf. Wie die Sperrlogik im Detail funktioniert, erklärt der Ratgeber robots.txt testen.
- Weiterleitungsketten nach einem Umzug: Alte Adresse A leitet auf B, B auf C. Zu lange Ketten und Schleifen meldet Google als „Weiterleitungsfehler“. Wie du Weiterleitungen beim Umzug planst, zeigt die Relaunch-Checkliste.
- Duplikate ohne klare kanonische Angabe: dieselbe Seite unter zwei Pfaden, mit und ohne Parameter oder als Druckfassung. Ohne Angabe wählt Google selbst, welche Fassung in den Index kommt.
- Dünne oder leere Seiten: Eine Seite ohne Hauptinhalt oder mit dem Hinweis, dass etwas nicht existiert, kann Google als „Soft 404-Fehler“ einstufen (Google zu Soft 404).
Wenn das Muster mehrere Seiten betrifft
Für eine einzelne neue Seite reicht die Prüfkette aus diesem Ratgeber. Wenn wichtige Seiten trotz Prüfung ausgeschlossen bleiben oder sich das Muster über mehrere URLs zieht, kann ein SEO-Audit technische und inhaltliche Ursachen systematisch eingrenzen. Als SEO-Dienstleister aus Münster sehe ich mir dabei Vorlagen, Weiterleitungen, kanonische Angaben und die Inhalte der betroffenen Seiten im Zusammenhang an. Welche Bereiche ein Audit grundsätzlich abdeckt, steht in der SEO-Audit-Checkliste.
Indexierungs-Prüfliste zum Ausdrucken
Die Prüfkette und die wichtigsten Statusmeldungen mit möglicher Ursache und erstem Schritt auf einer Seite, zum Ausdrucken und manuellen Ausfüllen.
Jetzt herunterladen (PDF)Häufige Fragen zur Google Indexierung
Wie lange dauert die Indexierung bei Google?
Eine feste Frist gibt es nicht. Für ein angefordertes Crawling nennt Google einige Tage oder mehrere Wochen. Bei einer neuen Website kann es einige Wochen dauern, bis Google sie bemerkt. Sofort geschieht die Indexierung laut Google nie, auch nicht direkt nach einem Antrag.
Wie beantrage ich die Indexierung bei Google?
In der Google Search Console: Adresse in die URL-Prüfung eingeben, „Live-URL testen“ wählen und, wenn die Seite als indexierbar gilt, auf „Indexierung beantragen“ klicken. Dafür brauchst du die Rolle Inhaber oder vollwertiger Nutzer. Ein Antrag ist keine Garantie für die Aufnahme, und mehrere Anträge für dieselbe Adresse beschleunigen nichts.
Wie prüfe ich, ob meine Seite bei Google indexiert ist?
Am verlässlichsten mit der URL-Prüfung in der Search Console. Sie zeigt den Indexstatus der Adresse und bei einem Ausschluss den Grund. Eine Suche mit site: und deiner Adresse ist ein schneller erster Blick: Erscheint die Seite, steht sie im Index. Erscheint sie nicht, ist das noch kein Beweis.
Was bedeutet „Gecrawlt, zurzeit nicht indexiert“?
Google hat die Seite abgerufen, aber nicht in den Index aufgenommen. Laut Google ist das für viele Websites üblich und nicht unbedingt ein Fehler. Betrifft es eine wichtige Seite, prüf sie mit der URL-Prüfung auf Sperren für Crawler und sieh dir an, ob sie genug eigenen Inhalt bietet.
Was bedeutet „Gefunden, zurzeit nicht indexiert“?
Google kennt die Adresse, hat sie aber noch nicht gecrawlt. Laut Google wollte der Googlebot normalerweise crawlen, das hätte die Website aber überlastet, deshalb wurde der Abruf verschoben. Sind viele Seiten betroffen, lohnt ein Blick auf die Antwortzeiten des Servers und auf unnötige Adressen, etwa aus Filtern.
Warum indexiert Google meine Seite nicht?
Den Grund nennt die URL-Prüfung. Typische Gründe sind ein vergessenes noindex, eine Sperre in der robots.txt, Weiterleitungen, Server- oder 404-Fehler und Duplikate, bei denen Google eine andere Fassung gewählt hat. Ist technisch alles in Ordnung, kann es am Inhalt liegen: Google priorisiert nach eigener Aussage qualitativ hochwertige und nützliche Inhalte.
Ist „Seite mit Weiterleitung“ ein Fehler?
In der Regel nicht. Eine Adresse, die weiterleitet, wird selbst nicht indexiert, in Frage kommt ihr Ziel. Prüf nur, ob die Weiterleitung gewollt ist und ob das Ziel selbst im Index steht.
Mehrere Seiten betroffen und kein Muster in Sicht?
Schreib mir im Formular weiter unten, welche Seiten betroffen sind und welche Meldung die Search Console zeigt. Ich melde mich mit einer Einschätzung bei dir.
Indexierung prüfen lassenWichtige Seiten bleiben trotz Prüfung draußen?
Schreib mir kurz deine Domain, welche Seiten betroffen sind und welche Meldung die Search Console dazu zeigt. Ich schaue mir die möglichen Ursachen an und melde mich bei dir.