Retrieval Augmented Generation: RAG für Firmenwissen erklärt
Retrieval Augmented Generation einfach erklärt: wie RAG Fragen zu Firmenwissen mit Quelle beantwortet, wo Grenzen liegen und wie du Datenquellen prüfst.
Inhaltsverzeichnis anzeigen
- Was ist RAG in der KI? Die Definition
- So funktioniert ein RAG-System in vier Schritten
- Chunks und Embeddings, kurz erklärt
- Wenn die Treffer nicht passen
- Das Beispiel durchgespielt: Antwort, keine Antwort, kein Zugriff
- Fall 1: Es gibt eine passende Passage
- Fall 2: Es gibt keine passende Passage
- Fall 3: Die Person darf die Quelle nicht sehen
- RAG, Fine-Tuning oder alles in den Prompt?
- Wann RAG für dein Firmenwissen reicht und wann nicht
- Datenquellen prüfen, bevor die KI sie liest
- Versionen und Widersprüche zuerst
- Lesbarkeit und Aufbereitung
- Risiken und Datenschutz bei RAG
- Datenflüsse, Speicherung und Verantwortliche
- Ist dein Firmenwissen bereit für RAG?
- Häufige Fragen zu Retrieval Augmented Generation
- Was ist RAG einfach erklärt?
- Was ist ein RAG-System?
- Was ist der Unterschied zwischen RAG und Fine-Tuning?
- Verhindert RAG Halluzinationen?
- Kann RAG lokal laufen?
- Welche Daten eignen sich für RAG?
- Was ist ein RAG-Chatbot?
Retrieval Augmented Generation, kurz RAG, ist ein Verfahren, bei dem eine KI vor ihrer Antwort passende Abschnitte aus deinen eigenen Dokumenten heraussucht und die Antwort darauf stützt. So beantwortet ein Sprachmodell Fragen zu Handbüchern, Richtlinien oder Servicefällen, die es aus seinem Training nicht kennt, und nennt im besten Fall die Quelle dazu. Die Grenze: Die Antworten sind nur so gut wie die Dokumente, aus denen das System sucht. Hier liest du, wie RAG funktioniert, wann es für dein Firmenwissen reicht und wie du deine Datenquellen vor dem Start prüfst.
- Was ist RAG? Die Frage wird vor der Antwort um passende Abschnitte aus einer Wissensbasis ergänzt.
- Vier Schritte: Dokumente aufbereiten, passende Abschnitte suchen, die Frage anreichern, mit Quellenangabe antworten.
- Halluzinationen: RAG verringert Halluzinationen, verhindert sie aber nicht.
- Rechte gehören in die Suche: Wer ein Dokument nicht sehen darf, darf auch dessen Abschnitte nicht als Treffer bekommen. Eine Anweisung im Prompt ersetzt das nicht.
- Vor dem Start: Jede Datenquelle auf Aktualität, Versionen, Zugriffsrechte, Lesbarkeit, Verantwortliche und sensible Inhalte prüfen. Die Prüfliste dazu gibt es als PDF.
Was ist RAG in der KI? Die Definition
Ein großes Sprachmodell, kurz LLM (Large Language Model), ist eine KI, die aus sehr vielen Texten gelernt hat, Sprache zu verstehen und zu erzeugen. Was nach seinem Training passiert ist oder nur in deiner Firma steht, kennt es nicht. Genau hier setzt RAG an. Amazon Web Services beschreibt RAG als Verfahren, das die Ausgabe eines Sprachmodells so verbessert, dass es vor der Antwort eine verlässliche Wissensbasis außerhalb seiner Trainingsdaten heranzieht. Microsoft nennt es ein Muster, das die Antworten eines Sprachmodells in deinen eigenen Inhalten verankert.
Die deutsche Datenschutzkonferenz (DSK) formuliert es so: Die Eingabe der Nutzenden wird um Texte aus Referenzdokumenten ergänzt, bevor sie an das Sprachmodell geht. Das BSI hebt hervor: Die Inhalte der Wissensdatenbank müssen dafür nicht vorher als Trainingsmaterial verwendet werden.
Den Begriff trägt ein Fachaufsatz von Patrick Lewis und Kollegen aus dem Jahr 2020 im Titel: „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“, angenommen auf der Konferenz NeurIPS 2020.
Stell dir eine neue Kollegin vor, die gut formulieren kann, aber deine Firma nicht kennt. Ohne Unterlagen antwortet sie aus dem Allgemeinwissen. Mit RAG legt ihr jemand vor jeder Frage die passenden Seiten aus dem Handbuch auf den Tisch. Sie antwortet dann auf dieser Grundlage und sagt dir, auf welcher Seite es steht.
So funktioniert ein RAG-System in vier Schritten
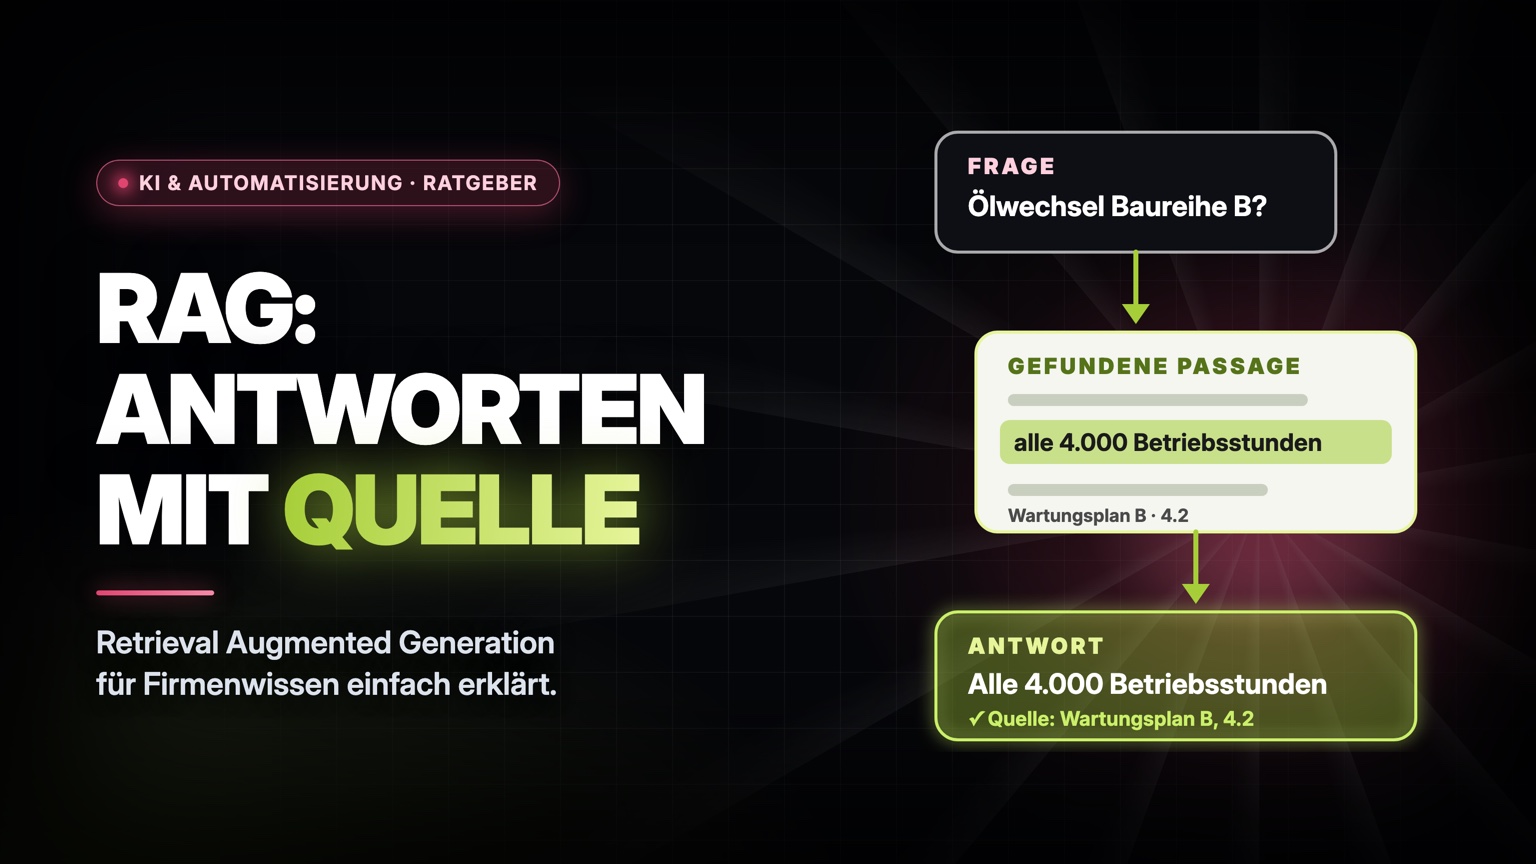
Ein RAG-System besteht aus zwei Teilen: einer Suche in deinen Dokumenten und einem Sprachmodell (LLM), das aus den Treffern eine Antwort formuliert. Das Schaubild zeigt den Ablauf an einem erfundenen Beispiel aus dem Maschinenbau.
Das Schaubild in Kürze:
- Schritt 1, Dokumente aufbereiten: Handbücher, Wartungspläne und Tickets werden in kurze Abschnitte zerlegt, die Chunks. Ein Embedding-Modell rechnet jeden Abschnitt in einen Zahlenvektor für seine Bedeutung um. Die Ablage erfolgt in einer Vektordatenbank.
- Schritt 2, passende Abschnitte suchen: Die Frage wird ebenso in einen Vektor umgerechnet. Die Suche liefert die Abschnitte, die der Frage inhaltlich am nächsten liegen.
- Schritt 3, Frage anreichern: Frage und gefundene Abschnitte gehen gemeinsam an das Sprachmodell.
- Schritt 4, antworten mit Quelle: Das Sprachmodell formuliert die Antwort aus den gefundenen Abschnitten. Die Antwort nennt Dokument und Abschnitt.
- Am Beispiel: Auf die Frage nach dem Ölwechsel der Baureihe B findet die Suche den Wartungsplan B, Abschnitt 4.2, und die Antwort nennt diese Quelle.
Chunks und Embeddings, kurz erklärt
Chunks sind die kurzen Abschnitte, in die das System deine Dokumente zerlegt. Anthropic beschreibt sie als Textstücke von meist höchstens einigen hundert Tokens. Ein Token ist die kleine Texteinheit, in der Sprachmodelle rechnen, oft ein Wort oder ein Wortteil. Die DSK spricht von kürzeren Absätzen. Stell dir Karteikarten vor statt eines ganzen Ordners.
Ein Embedding ist eine Zahlenreihe, die die Bedeutung eines Abschnitts beschreibt. Abschnitte mit ähnlichem Inhalt bekommen ähnliche Zahlen, auch wenn andere Wörter darin stehen. Gespeichert werden sie in einer Vektordatenbank, einer Datenbank, die nach inhaltlicher Nähe sucht statt nach exakt gleichen Wörtern. Deshalb findet die Suche den Abschnitt über den „Wechsel des Hydrauliköls“ auch dann, wenn jemand nach dem „Ölwechsel an der Presse“ fragt.
Wenn die Treffer nicht passen
Eine reine Bedeutungssuche hat eine bekannte Schwäche. Laut Anthropic übersehen Embedding-Modelle manchmal exakte Übereinstimmungen, etwa eindeutige Kennungen wie einen Fehlercode. Sucht dein Team oft nach Artikelnummern, Fehlercodes oder Normbezeichnungen, gibt es zwei mögliche Verbesserungen, die Google Cloud und Microsoft beschreiben:
- Hybride Suche: Bedeutungssuche und klassische Stichwortsuche laufen zusammen. So zählen auch exakte Treffer auf Kennungen.
- Reranking: Ein zweiter Schritt bewertet die gefundenen Abschnitte noch einmal und sortiert die relevantesten nach oben.
Beides ist kein Pflichtbestandteil. Ich würde es dann ergänzen, wenn Tests mit echten Fragen aus deinem Team zeigen, dass die richtigen Abschnitte nicht oben landen.
Das Beispiel durchgespielt: Antwort, keine Antwort, kein Zugriff
Angenommen, ein Maschinenbauer legt seine Bedienhandbücher, Wartungspläne und Servicetickets in ein RAG-System. Handbücher und Wartungspläne darf das ganze Serviceteam lesen. Die Servicetickets enthalten Namen und Anlagen von Kunden, deshalb dürfen nur der Kundendienst und die Serviceleitung sie sehen. Drei Fragen zeigen, wie sich ein gut eingerichtetes System verhält.
Fall 1: Es gibt eine passende Passage
- Frage: „Wann wird das Hydrauliköl der Baureihe B gewechselt?“
- Gefundene Passage: Wartungsplan B, Abschnitt 4.2: „Hydrauliköl alle 4.000 Betriebsstunden wechseln.“
- Antwort: „Alle 4.000 Betriebsstunden. Quelle: Wartungsplan B, Abschnitt 4.2.“
- Quellenprüfung: Die Technikerin öffnet den Abschnitt über den Link in der Antwort und prüft, ob dort wirklich diese Zahl steht und ob der Plan die gültige Fassung ist.
Liegt neben dem aktuellen Wartungsplan noch eine alte Fassung mit einem anderen Intervall in der Ablage, kann das System korrekt aus der alten Fassung zitieren. Die Quelle stimmt dann, die Antwort ist trotzdem veraltet. Eine Quellenangabe macht die Antwort prüfbar, nicht automatisch richtig.
Fall 2: Es gibt keine passende Passage
Ein Monteur fragt nach dem Ölwechsel der Baureihe D. Für diese Baureihe liegt kein Wartungsplan in der Wissensbasis. Ein gut eingerichtetes System antwortet dann: „In den freigegebenen Dokumenten habe ich dazu keine Angabe gefunden.“ Es rät nicht und überträgt nicht einfach den Wert der Baureihe B. Dieses Verhalten entsteht nicht von selbst, es wird bei der Einrichtung festgelegt. Ich würde deshalb immer Testfragen aufnehmen, auf die es in den Dokumenten bewusst keine Antwort gibt.
Fall 3: Die Person darf die Quelle nicht sehen
Ein Auszubildender fragt, welche Störungen es zuletzt an der Anlage eines bestimmten Kunden gab. Die Antwort stünde in den Servicetickets, die er nicht sehen darf. Die Suche filtert diese Tickets für ihn heraus, bevor überhaupt etwas an das Sprachmodell geht. Das Modell bekommt die Passage nie zu sehen und kann sie deshalb auch nicht verraten. Das System meldet, dass es in den für ihn freigegebenen Dokumenten nichts gefunden hat. Microsoft nennt das Sicherheitsfilter auf Dokumentebene und bringt ein passendes Beispiel: Finanzdaten bleiben dem Finanzteam vorbehalten, auch wenn jemand aus der Geschäftsführung den Chatbot fragt.
RAG, Fine-Tuning oder alles in den Prompt?
RAG ist nicht der einzige Weg, einem Sprachmodell Firmenwissen mitzugeben. OpenAI beschreibt die Verfahren als verschiedene Hebel, die verschiedene Dinge lösen. Fine-Tuning, also das Nachtrainieren eines Modells mit Beispielen, bringt ihm laut OpenAI eher eine Aufgabe bei, laut Microsoft auch einen Stil oder ein Format. Beides lässt sich laut OpenAI kombinieren. Die DSK zitiert dazu das Fraunhofer IESE: Fine-Tuning sollte nicht dafür eingesetzt werden, einem Sprachmodell Wissen anzutrainieren.
| Weg | Zweck | Aktualität | Aufwand | Grenze |
|---|---|---|---|---|
| RAG | Fragen aus eigenen Dokumenten beantworten, mit Quellenangabe | Dokumente lassen sich ändern und löschen, ohne das Modell anzufassen | Dokumente aufbereiten, Suche einrichten, Index bei Änderungen nachziehen | Schwache oder widersprüchliche Dokumente ergeben schwache Antworten |
| Fine-Tuning | Aufgabe, Antwortstil oder Ausgabeformat zuverlässig beibringen | Neues Wissen erfordert ein neues Training | Beispiele aus Frage und erwarteter Antwort erstellen und trainieren | Laut Fraunhofer IESE nicht dafür gedacht, Wissen anzutrainieren |
| Alles in den Prompt | Kleine Wissensbasis komplett mitgeben | So aktuell wie die Unterlagen, die du jedes Mal mitschickst | Gering beim Start, jede Anfrage trägt aber das ganze Material | Passt nur, solange das Material ins Kontextfenster passt |
Zur dritten Zeile gibt es eine konkrete Herstellerangabe. Anthropic schrieb in einem Fachbeitrag zu seinem Verfahren „Contextual Retrieval“: Ist deine Wissensbasis kleiner als 200.000 Tokens, etwa 500 Seiten, kannst du sie komplett in den Prompt geben, ohne RAG. Das ist eine Herstellerangabe zu den Claude-Modellen zur Zeit des Beitrags. Fenstergrößen ändern sich seitdem. Google Cloud empfiehlt RAG, wenn das Material nicht mehr ins Kontextfenster passt oder die Leistung skalieren soll, weil RAG dann Tokens, Zeit und Kosten spart. Microsoft warnt, dass das Mitschicken großer Dokumentmengen Tokens verschwendet und die Qualität senkt.
Wann RAG für dein Firmenwissen reicht und wann nicht
Fünf Fragen helfen bei der Einordnung.
RAG kann nur finden, was aufgeschrieben ist. Wissen, das nur in Köpfen steckt, muss erst dokumentiert werden.
Ein schmales Regelwerk passt womöglich komplett in den Prompt. Tausende Seiten aus mehreren Ablagen sprechen für eine Suche.
Laut DSK lassen sich Inhalte in einem RAG-System einfach aktualisieren und löschen, anders als im Modell erlerntes Wissen.
Laut DSK lässt sich im Sprachmodell selbst nicht steuern, wer auf welche Informationen zugreifen darf.
Die DSK weist darauf hin, dass lange Wenn-dann-Ketten über viele Textstellen verteilt sein können und dann nur teilweise in der Anfrage landen.
Ein RAG-Chatbot für Kunden folgt demselben Prinzip, stellt aber eigene Anforderungen an Tonfall, Übergabe an Menschen und Kennzeichnung. Was dabei zählt, beschreibt der Ratgeber zum KI-Chatbot im Unternehmen. Welches Sprachmodell sich als Grundlage eignet, vergleicht der Beitrag LLM-Vergleich für Unternehmen.
Datenquellen prüfen, bevor die KI sie liest
Die DSK schreibt es deutlich: Die Zuverlässigkeit von RAG-Systemen hängt stark von Qualität, Aktualität und Vollständigkeit der Referenzdokumente ab. Unvollständige oder veraltete Daten führen zu unrichtigen Ausgaben. Bevor eine Ablage angeschlossen wird, würde ich deshalb jede Datenquelle einzeln prüfen, also jedes Laufwerk, jedes Wiki und jedes Ticketsystem. Sechs Punkte gehören auf die Liste, die es am Ende des Artikels auch als PDF gibt.
- Aktualität: Ist erkennbar, welcher Stand gilt, und wird die Quelle laufend gepflegt?
- Dubletten und Versionen: Liegen alte Fassungen, Entwürfe oder Kopien neben der gültigen Version?
- Zugriffsrechte: Ist für jedes Dokument festgelegt, wer es sehen darf, und lässt sich das ins System übernehmen?
- Format und Lesbarkeit: Ist der Text maschinenlesbar, oder stecken Inhalte in eingescannten Seiten, Bildern und Tabellen?
- Verantwortliche Person: Wer pflegt die Quelle und entscheidet, wenn zwei Dokumente sich widersprechen?
- Ausschluss sensibler Inhalte: Welche Inhalte gehören gar nicht in die Wissensbasis, etwa Personalakten oder Gesundheitsdaten?
Versionen und Widersprüche zuerst
Besonders wichtig ist der zweite Punkt. OWASP beschreibt in seiner Risikoliste für Sprachmodelle Wissenskonflikte, wenn Daten aus mehreren Quellen einander widersprechen. Die DSK ergänzt, dass ein Sprachmodell bei widersprüchlichen Inhalten dazu neigen kann, auf sein Trainingswissen zurückzufallen und die Referenzdokumente zu verwerfen. Fall 1 aus dem Beispiel zeigt, warum das zählt. Alte Versionen archivierst du deshalb außerhalb der Wissensbasis, statt sie daneben liegen zu lassen.
Lesbarkeit und Aufbereitung
Die DSK empfiehlt, störende Daten wie Kopf- und Fußzeilen oder Seitennummern vor dem Zerlegen in Abschnitte zu bereinigen. Bei deutschsprachigen Dokumenten sollte das Embedding-Modell mit deutschsprachigen Texten trainiert sein. Und wenn sich Dokumente ändern, müssen auch ihre Embeddings neu berechnet werden, wie AWS beschreibt.
Risiken und Datenschutz bei RAG
RAG verbessert vieles, löst aber nicht alles. Die DSK schreibt, dass RAG Halluzinationen und unrichtige Ausgaben in gewissem Umfang reduziert und Herausforderungen bestehen bleiben. Google Cloud nennt einen typischen Fall: Sind die gefundenen Informationen unpassend, kann die Antwort zwar darauf gestützt sein und trotzdem am Thema vorbeigehen.
- Rechte nur im Prompt: Das BSI rät ausdrücklich davon ab, ein Rechte- und Rollensystem über Textanweisungen umzusetzen, weil das angreifbar ist. Rechte müssen schon die Suche begrenzen, also das, was überhaupt abgerufen werden kann.
- Anweisungen in Dokumenten: OWASP führt Prompt Injection als Risiko LLM01:2025. Ein Angreifer verändert ein Dokument in der Ablage, und die eingeschleusten Anweisungen darin beeinflussen die Antwort. Laut OWASP beseitigen RAG und Fine-Tuning dieses Risiko nicht vollständig. Text aus Dokumenten ist deshalb Inhalt, kein Befehl, und darf dem System keine zusätzlichen Rechte verschaffen.
- Vergiftete Wissensbasis: Das BSI warnt, dass Angreifende manipulierte Inhalte in die Wissensbasis einschleusen können. OWASP beschreibt unter LLM08:2025 ein Beispiel mit weißem Text auf weißem Grund in einem Lebenslauf. Dokumente aus unbekannten Quellen sollten laut DSK nicht verwendet werden.
Datenflüsse, Speicherung und Verantwortliche
Die stärkste deutsche Quelle zum Thema ist die Orientierungshilfe der DSK zu RAG (Version 1.0, Oktober 2025). Sie sieht Vorteile, etwa nachvollziehbarere Ausgaben und Inhalte, die sich löschen und beauskunften lassen. Sie stellt aber auch klar: Ein RAG-System ändert nichts daran, wie das Sprachmodell trainiert wurde, und das Löschen im Modell selbst bleibt schwierig. Außerdem sieht die DSK in der Nutzung eines RAG-Systems eine Bedrohung für die Zweckbindung. Die Bewertung muss laut DSK im Einzelfall erfolgen. Die Orientierungshilfe der DSK geht von einem System aus, das komplett im eigenen Haus bei einem Verantwortlichen läuft. Bei Cloud-Diensten oder Dienstleistern kommen weitere Fragen dazu.
Für deine Planung heißt das, vier Dinge schriftlich zu klären:
- Datenflüsse: Wohin gehen Fragen, gefundene Abschnitte und Antworten? Ein Bericht aus dem Expertenpool des Europäischen Datenschutzausschusses, der laut eigenem Hinweis nicht unbedingt dessen offizielle Position wiedergibt, nennt als typische Risiken unsicher gespeicherte Protokolle, Anfragen an externe Dienste und vertrauliche Daten in der Wissensbasis.
- Berechtigungen: Wer darf welche Quelle durchsuchen, und wie kommen diese Rechte aus deinen bestehenden Systemen ins neue System?
- Speicherung: Wo liegen Vektordatenbank und Protokolle, wie lange, wie wird gelöscht, und wer darf die Protokolle auswerten?
- Verantwortliche: Wer ist für das System verantwortlich, und welche Dienstleister verarbeiten Daten in deinem Auftrag? Nutzt du Cloud-Dienste für Suche, Vektordatenbank oder Sprachmodell, gehören, sobald personenbezogene Daten im Spiel sind, ein Vertrag zur Auftragsverarbeitung und bei Anbietern außerhalb von EU und EWR die Frage des Drittlandtransfers dazu.
Lokaler Betrieb hilft bei einem Teil davon. Die DSK nennt als Vorteil, dass sich die Übertragung personenbezogener Daten an Online-Betreiber großer Sprachmodelle vermeiden lässt. Rechtsgrundlage, Zweckbindung, Löschung und Zugriffsrechte bleiben aber auch im eigenen Haus deine Aufgabe. Lokaler Betrieb allein garantiert also keinen Datenschutz. Was beim Betrieb im eigenen Haus zu bedenken ist, steht im Ratgeber zur lokalen KI, die allgemeinen Pflichten im Beitrag KI und Datenschutz nach der DSGVO.
Dieser Beitrag gibt einen praxisorientierten Überblick und ersetzt keine Rechtsberatung. Gesetzeslage und Auslegung können sich ändern, Stand November 2026. Bei konkreten Fragen oder Grenzfällen ziehe bitte eine Anwältin, einen Anwalt oder deine Datenschutzberatung hinzu. inventivo unterstützt bei der technischen und organisatorischen Umsetzung, nicht bei der rechtlichen Bewertung.
Ist dein Firmenwissen bereit für RAG?
Wenn du klären möchtest, ob deine Dokumente für eine verlässliche interne Wissenssuche geeignet sind, unterstütze ich dich bei Datenprüfung und Umsetzung. Wie das abläuft, steht auf der Seite KI-Wissensmanagement. Seit 2004 entwickle ich in Münster Websites, Shops und Schnittstellen für kleine und mittlere Unternehmen.
Quellen: AWS, What is RAG?; Microsoft, RAG-Überblick und Security filters for trimming results; Google Cloud, Retrieval-augmented generation; OpenAI, Optimizing LLM accuracy; Anthropic, Contextual Retrieval; OWASP, LLM01:2025 Prompt Injection und LLM08:2025 Vector and Embedding Weaknesses; BSI, Generative KI-Modelle (Version 2.0); DSK, Orientierungshilfe RAG; EDPB Support Pool of Experts, AI Privacy Risks & Mitigations. Englische Seiten sinngemäß übersetzt, abgerufen am 18.11.2026.
RAG-Prüfliste für Datenquellen als PDF
Die sechs Prüfpunkte als Tabelle für bis zu drei Datenquellen, mit Feldern für Prüfdatum, ausgeschlossene Inhalte und nächsten Prüftermin. Eine Seite zum Ausdrucken und manuellen Ausfüllen.
Jetzt herunterladen (PDF)Häufige Fragen zu Retrieval Augmented Generation
Was ist RAG einfach erklärt?
RAG steht für Retrieval Augmented Generation. Die KI sucht vor ihrer Antwort passende Abschnitte aus einer Wissensbasis, zum Beispiel aus deinen Handbüchern, und formuliert die Antwort auf dieser Grundlage.
Was ist ein RAG-System?
Ein RAG-System verbindet eine Suche in deinen Dokumenten mit einem Sprachmodell. Dazu gehören die Aufbereitung in Abschnitte, ein Embedding-Modell, eine Vektordatenbank, die Suche und das Sprachmodell, das die Antwort schreibt und die verwendeten Quellen nennt. Wer von einem RAG-Modell spricht, meint in der Regel dieses Zusammenspiel aus Suche und Sprachmodell.
Was ist der Unterschied zwischen RAG und Fine-Tuning?
RAG holt Wissen aus Dokumenten, die du jederzeit ändern kannst. Fine-Tuning trainiert ein Modell mit Beispielen nach, damit es eine Aufgabe, einen Stil oder ein Format zuverlässig beherrscht. Für Firmenwissen, das sich ändert, ist RAG meist der passendere Weg. Beide Verfahren lassen sich kombinieren.
Verhindert RAG Halluzinationen?
Nein. RAG verringert Halluzinationen, weil das Modell sich auf gefundene Abschnitte stützt, verhindert sie aber nicht.
Kann RAG lokal laufen?
Ja. Suche, Vektordatenbank und Sprachmodell können auf eigener Hardware im Unternehmen laufen. Dann lässt sich vermeiden, dass Daten an einen KI-Anbieter gehen. Die übrigen Pflichten zum Datenschutz bleiben bestehen. Was du dafür brauchst, beschreibt der Ratgeber zur lokalen KI.
Welche Daten eignen sich für RAG?
Gut geeignet sind gepflegte, textbasierte Dokumente mit klarem Stand, etwa Handbücher, Arbeitsanweisungen, Richtlinien oder gelöste Servicefälle. Schwierig sind Ablagen voller alter Fassungen, eingescannte Seiten und Dokumente mit unklaren Zugriffsrechten.
Was ist ein RAG-Chatbot?
Ein RAG-Chatbot beantwortet Fragen im Dialog und holt sich dafür passende Abschnitte aus einer festgelegten Wissensbasis, intern etwa für das Serviceteam, extern für Kundenfragen. Entscheidend ist, dass er ohne passende Passage keine Antwort erfindet. Das legst du bei der Einrichtung fest und prüfst es mit Testfragen.
Willst du wissen, ob deine Dokumente RAG tragen?
Ein paar Sätze zu deinen Datenquellen und zu dem, was die Suche beantworten soll, genügen im Formular weiter unten.
Datenprüfung anfragenSind deine Dokumente bereit für eine KI-Suche?
Schreib mir kurz, welche Dokumente die Suche beantworten soll, wo sie liegen und wer sie sehen darf. Ich schaue mir an, ob sich deine Unterlagen für eine verlässliche interne Wissenssuche eignen, und melde mich bei dir.